接口 200 却永远没有下文:一次跨四系统的超时根修与告警人脸上线排查
导读
生产环境上传素材返回 200,审批也点了同意,素材列表却永远空空如也。同一天另一片场:告警人脸功能上线,规则建好了、平台却”看不到人脸”。两个故障表面毫不相干,收尾时却发现它们共用同一套排查方法论:先用最硬的证据定层,再一次只换一个变量。本篇把两条排查线完整复盘。
前言
9 月 1 日的主线是两条:一是 smart 信息发布的素材审批在生产上”静默消失”,二是告警人脸功能上线后的第一轮排障。前者横跨 smart、bpm、iot、大华网关四个系统,后者横跨 security、through、integrate-iot 和 VPlat 平台。两个问题的代码链路最终都被证明是无辜的——真正的问题藏在超时配置、数据状态和上游平台行为里。
故事一:接口 200,素材永远不出现
症状
页面上传素材返回 200,素材列表看不到;走完整条审批流点”同意”,列表里依然没有。当天三次上传全部复现:两段 17MB 的 mp4,一张小 jpg。
链路:四个系统串成一条,三处要害
上传阶段(smart 落库 + 发起 bpm 审批)一直是对的——返回 200 只证明第一阶段成功。真正断的是后半段:审批结束 → bpm 回调 smart → smart 同步大华 → 全部做完才落 audit_status=1。
三处要害后来都成了修复点:
- 外部副作用排在核心状态前面:拉文件、转换、传大华全部做完才落库,中途任何异常都跳过落库;
- 回调吞掉一切异常:bpm 侧
invokeCallbackSafely捕获所有异常只记日志、不重试,失败后再没有人会试第二次; - 读超时一刀切 15s:iot 出口的 RestTemplate 对所有接口一视同仁,包括”上传 17MB 视频给大华做同步转码”这种天然慢的操作。
分层取证:从 DB 一路挖到最底层异常
取证顺序自上而下:先看数据,再看每一层的日志,最后才碰对端。
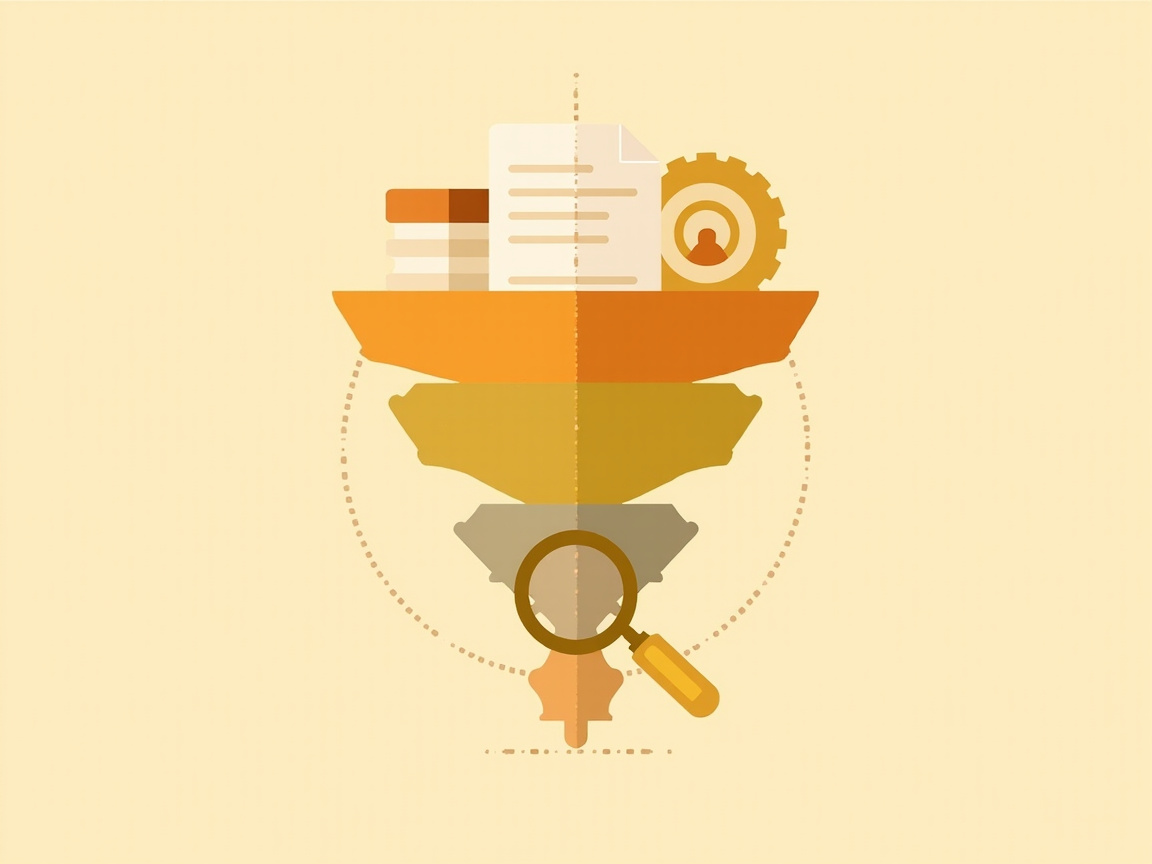
图 1:分层取证——先看最硬的数据库证据,再逐层翻日志,最后才动对端
第一步在数据库就拿到了定性证据:三行记录 audit_status=0 且 update_time == create_time——记录从未被更新过,说明更新方从未成功执行,比任何日志都硬。之后的路线是:bpm-error.log 两次”流程结束业务回调失败 500” → smart 日志确认进了同意分支、Feign 500 → iot-error.log 最底层栈 SocketTimeoutException: Read timed out。最后一步是时间对账:进入审核到报错 19.5s ≈ 拉文件转发 4s + 干等 15s 读超时,数字对上,机制闭环。
三个错误假设是怎么倒下的
排查中走了三条弯路,每条都是”没实测前的推断”:
| 错误假设 | 被什么否掉 |
|---|---|
| 网关挂了 / NAT 问题 | curl 探测:GET 与正常 POST 都活着,只有空 body 的 POST 被 RST |
| 不用带参数 | 上游 Postman 集合里 upload 恰好没存 body,差点带沟里去;参数形态是从对方截图反推的 |
| NAT 对大包有问题 | 对称实验:17MB mp4 原样复刻请求,200 成功,总耗时 30s+ |
决定性的一行是第三个实验:大华收到文件后会同步做 h264 转码和缩略图,大视频响应 30s+ 是常态。通道一直是通的——不是网关、不是 NAT、不是参数,就是 iot 的 15s 读超时必挂。
顺带两条教训:HTTP 200 ≠ 业务成功(传输层 200、业务层照样 200027 拒绝);对称实验”一次只换一个变量”是逐个排除假设的关键。
修复:三处改动,每处对着一个要害
iot 侧:上传专用长超时。 15s 对查询/下发类接口是合理的快速失败层,全局放大等于放弃熔断,所以只给”上传”这一类天然慢的操作单独放行 180s(实测 17MB 要 30s+,留五倍余量):
smart 侧:审批结果无条件落库。 设备同步整段 try/catch,失败只记日志、不再中途 return:
取舍要说清楚:外部副作用(传设备)不应绑架核心状态(审批结果)。代价是同步失败时素材可见但 factory_material_id 为空,链路恢复后需重传——与”审批同意了却永远看不到素材”相比,这是可接受且可恢复的失败模式。另外顺手修了 bpm 侧一个一行 bug:审批意见取错变量,把 formBusinessId 写进了 audit_reason。
故事二:告警人脸——“规则建了但平台看不到人脸”
同一天的另一片场。结论先行:代码链路无问题,排查出的全是数据/配置/上游平台问题。
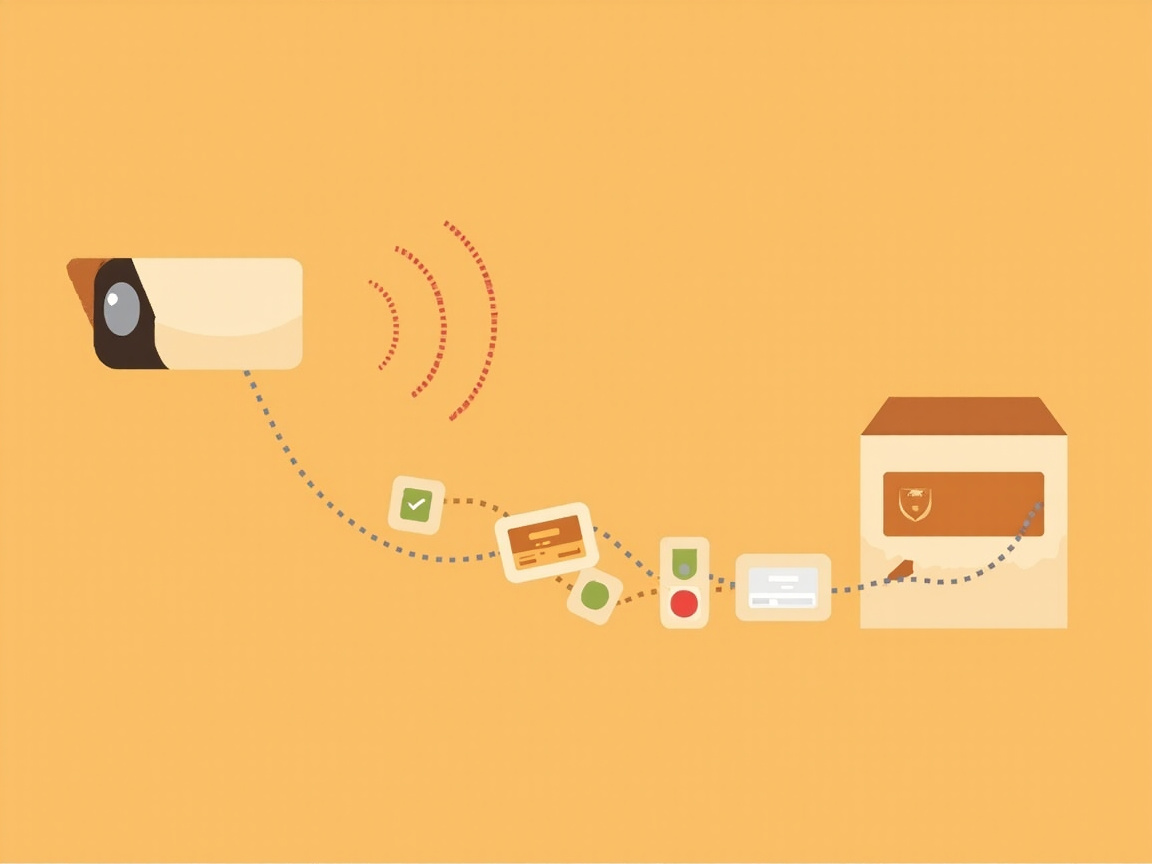
图 2:人脸下发链路——规则刷新决策 → 队列入库 → 同步器上传注册 → 回写 ai_face_id
三个典型现象对应的根因:
| 现象 | 根因 | 处置 |
|---|---|---|
| 队列表一行都没有 | 规则 enable_status='1'(暂不启用)不算引用;成员照片待校验不入队 |
启用规则 + 审批通过照片,启停一次规则触发 refresh |
| 队列有记录但”网关接口调用失败” | VPlat 平台拒收图片(照片质量/检测不到人脸),不是网络问题 | 换正脸照重新上传审批,启停规则重试 |
| 手工 UPDATE 报 Error 1175 | MySQL safe update mode | SET SQL_SAFE_UPDATES=0 包裹执行 |
排查顺序的核心是先怀疑决策层,再怀疑同步器:刷新决策日志里”成员数=N,有效人员数=N,入队数=N”,入队为 0 说明决策层判定无有效人员,根本轮不到同步器背锅。另一个关键认知:人脸组只是容器,不承载校验规则——检测参数在摄像头策略层,”谁触发告警”在平台规则匹配层,换组不会改变校验行为,别往那个方向排查。
方法论沉淀
两条线收尾后,沉淀下来的东西是一样的:
- 先量总耗时、再下结论:超时类问题必须拿到对端真实行为,数字对不上时机制一定没找对;
- update_time == create_time 是最便宜的定性证据:它比任何日志都先告诉你”更新方根本没跑成”;
- 对称实验一次只换一个变量:字段照抄、文件名统一 ASCII,逐个假设排除;
- HTTP 200 只代表传输层:业务码、回调链、副作用落库,每一层都值得单独验证;
- 外部副作用不许绑架核心状态:传设备失败可以重传,审批结果被绑架就是事故。
结语
两个”看起来像代码 bug”的问题,最后都落在配置、数据和上游行为上。排查的价值不在于修好这一次,而在于把”先定层、再变量隔离”这套动作变成肌肉记忆——下一次故障来临时,它能帮你省掉前三个错误假设。